PINNs: Cuando las Leyes de la Física Guían a las Redes Neuronales
Índice de contenido7›
Durante la última década, el auge del aprendizaje profundo (Deep Learning) ha descansado de manera hegemónica sobre un dogma empírico: extraer patrones estadísticos a partir de volúmenes titánicos de datos. Si el objetivo consiste en reconocer peatones en una vía urbana, transcribir audio en tiempo real o predecir la siguiente palabra en un modelo masivo de lenguaje, la receta estándar ha sido siempre la misma: suministrar cientos de miles o millones de ejemplos anotados para que los pesos sinápticos se ajusten por descenso de gradiente.
Sin embargo, cuando la inteligencia artificial intenta adentrarse en los dominios de la física teórica, la astrofísica, la geofísica o la ingeniería aeroespacial, este dogma choca frontalmente contra la realidad del mundo tangible: en la naturaleza, los datos suelen ser escasos, ruidosos, extremadamente costosos de adquirir o físicamente inaccesibles. No es posible sembrar miles de sensores térmicos en el núcleo de un reactor de fusión confinada por plasma a cien millones de grados Celsius, ni perforar milimétricamente el interior de un álabe de turbina en pleno vuelo supersónico, ni reconstruir con tomografía de alta resolución el campo de velocidades sanguíneas en cada microvaso capilar del cerebro humano.
¿Tiene sentido exigirle a una red neuronal que deduzca desde la ignorancia absoluta los principios fundamentales de la naturaleza, obligándola a redescubrir a ciegas las leyes de conservación que a la humanidad le tomó tres siglos formalizar? La respuesta a esta interrogante epistemológica marca el nacimiento de una de las ramas más fecundas de la ciencia contemporánea: el Machine Learning Científico (Scientific Machine Learning o SciML) y, muy especialmente, las Redes Neuronales Informadas por la Física (Physics-Informed Neural Networks, conocidas por el acrónimo PINNs).
La forja del concepto: De las costas de Creta a los laboratorios de Brown
La integración entre la mecánica continua clásica y el aprendizaje computacional no surgió de un vacío fortuito, sino de una prolongada maduración académica encabezada por figuras que dominaban ambos mundos:
1. George Em Karniadakis y la escuela de Brown
La figura cardinal en la cristalización moderna de las PINNs es el matemático e ingeniero greco-estadounidense George Emmanouil Karniadakis (Γιώργος Εμμανουήλ Καρνιαδάκης; admirado por su prolífica visión al tender un puente epistemológico indisoluble entre el análisis numérico continuo y las redes neuronales profundas; n. en Creta, Grecia).
Nacido en la histórica isla de Creta en el mar Egeo —cuna marítima donde convergen el mito y la navegación antigua—, Karniadakis creció con una marcada fascinación por la hidrodinámica y la mecánica de medios continuos. Se trasladó a Atenas para formarse en la prestigiosa Universidad Politécnica Nacional de Atenas (Ethnikó Metsóvio Polytechneío), donde obtuvo en 1982 su diploma de ingeniería en Ingeniería Mecánica y Arquitectura Naval (Naval Architecture).
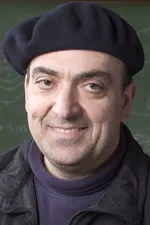 George Emmanouil Karniadakis, catedrático Charles Pitts Robinson y John Palmer Barstow de Matemáticas Aplicadas en la Universidad de Brown y director del grupo de investigación CRUNCH. Fuente: Wikimedia Commons / CC BY-SA.
Decidido a explorar las fronteras del cálculo científico, emigró a los Estados Unidos para ingresar al Instituto Tecnológico de Massachusetts (MIT). Allí obtuvo su maestría en ciencias (Scientiae Magister, 1984) y su doctorado en Ingeniería Mecánica y Matemáticas Aplicadas en 1987, bajo la tutela doctoral de Anthony T. Patera y Borivoje B. Mikić. Su trayectoria posterior lo condujo al célebre Centro de Investigación de Turbulencia (Center for Turbulence Research) de la Universidad de Stanford y el Laboratorio Ames de la NASA, donde trabajó codo a codo con pioneros del modelado turbulento como Parviz Moin y John Kim.
Tras ejercer como profesor asistente en la Universidad de Princeton y realizar estancias en Caltech, Karniadakis recaló en 1994 en la División de Matemáticas Aplicadas de la Universidad de Brown, en Providence (Rhode Island), institución donde consolidaría su célebre grupo de investigación CRUNCH y asumiría la dirección del consorcio PhILMS (Physics-Informed Learning Machines for Multiscale and Multiphysics Problems), financiado por el Departamento de Energía de los Estados Unidos (DOE). Reconocido internacionalmente por desarrollar métodos espectrales de elementos finitos de alto orden (spectral/hp-element methods) y la cuantificación de incertidumbre en ecuaciones diferenciales estocásticas, Karniadakis comprendió tempranamente que el Deep Learning no debía concebirse como un reemplazo de la física matemática, sino como un colaborador simbiótico.
2. Los antecedentes helenos: Isaac Lagaris y las redes de prueba (1998)
Aunque el término y la formulación contemporánea de las PINNs eclosionaron entre 2017 y 2019, la semilla analítica original se remonta dos décadas atrás. En septiembre de 1998, un equipo de investigadores griegos de la Universidad de Ioannina —encabezado por Isaac E. Lagaris, Aristidis Likas y Dimitrios I. Fotiadis— publicó en IEEE Transactions on Neural Networks un artículo fundacional titulado «Artificial neural networks for solving ordinary and partial differential equations».
Lagaris y sus colegas propusieron construir soluciones de prueba (trial solutions) donde la salida de la red neuronal se descomponía algebraicamente en dos sumandos: una función analítica que satisfacía exactamente las condiciones de frontera o iniciales, y un término modulado por un perceptrón que se optimizaba para minimizar el residuo de la ecuación diferencial. En los años noventa, sin embargo, el hardware era modesto, las funciones de activación como la sigmoide sufrían de desvanecimiento de gradiente (vanishing gradient) y las herramientas de cálculo computacional requerían engorrosas derivaciones simbólicas a mano para cada operador diferencial.
3. El renacimiento contemporáneo (2017–2019): Raissi, Perdikaris y Karniadakis
A finales de 2017, dos brillantes investigadores posdoctorales del grupo de Karniadakis en Brown, Maziar Raissi y Paris Perdikaris, publicaron dos preprints históricos que en 2019 se consolidaron en el Journal of Computational Physics: «Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations».
La gran revolución de Raissi, Perdikaris y Karniadakis radicó en aprovechar la Diferenciación Automática (Automatic Differentiation, AD) en modo inverso (backpropagation), un mecanismo nativo de los modernos marcos de cómputo tensorial (TensorFlow, PyTorch, JAX). Gracias a la AD, ya no era necesario aproximar derivadas espaciales ni temporales con mallas de diferencias finitas, ni derivar expresiones analíticas monstruosas: el propio grafo computacional de la red calculaba las derivadas parciales exactas de la solución con respecto a las coordenadas del espacio y el tiempo.
La maquinaria matemática: ¿Cómo aprende una PINN?
Para comprender el funcionamiento interno de una PINN, podemos formular el problema canónico de una ecuación diferencial en derivadas parciales (EDP) parametrizada en un dominio continuo espacio-temporal $\Omega \times [0, T] \subset \mathbb{R}^d \times \mathbb{R}$:
$$\partial_t u(\mathbf{x}, t) + \mathcal{N}_{\mathbf{x}}[u(\mathbf{x}, t)] = 0, \quad \mathbf{x} \in \Omega, \quad t \in [0, T]$$
donde $u(\mathbf{x}, t)$ representa el campo físico de interés (por ejemplo, la temperatura, la presión o el campo de velocidades de un fluido) y $\mathcal{N}_{\mathbf{x}}$ denota un operador diferencial no lineal en el espacio (que puede incorporar términos advectivos como $u \cdot \nabla u$ o disipativos como el laplaciano $-\nu \Delta u$).
El sistema se complementa con una condición inicial en $t = 0$:
$$u(\mathbf{x}, 0) = g(\mathbf{x}), \quad \mathbf{x} \in \Omega$$
y condiciones de frontera sobre el contorno $\partial\Omega$:
$$\mathcal{B}[u](\mathbf{x}, t) = h(\mathbf{x}, t), \quad \mathbf{x} \in \partial\Omega, \quad t \in [0, T]$$
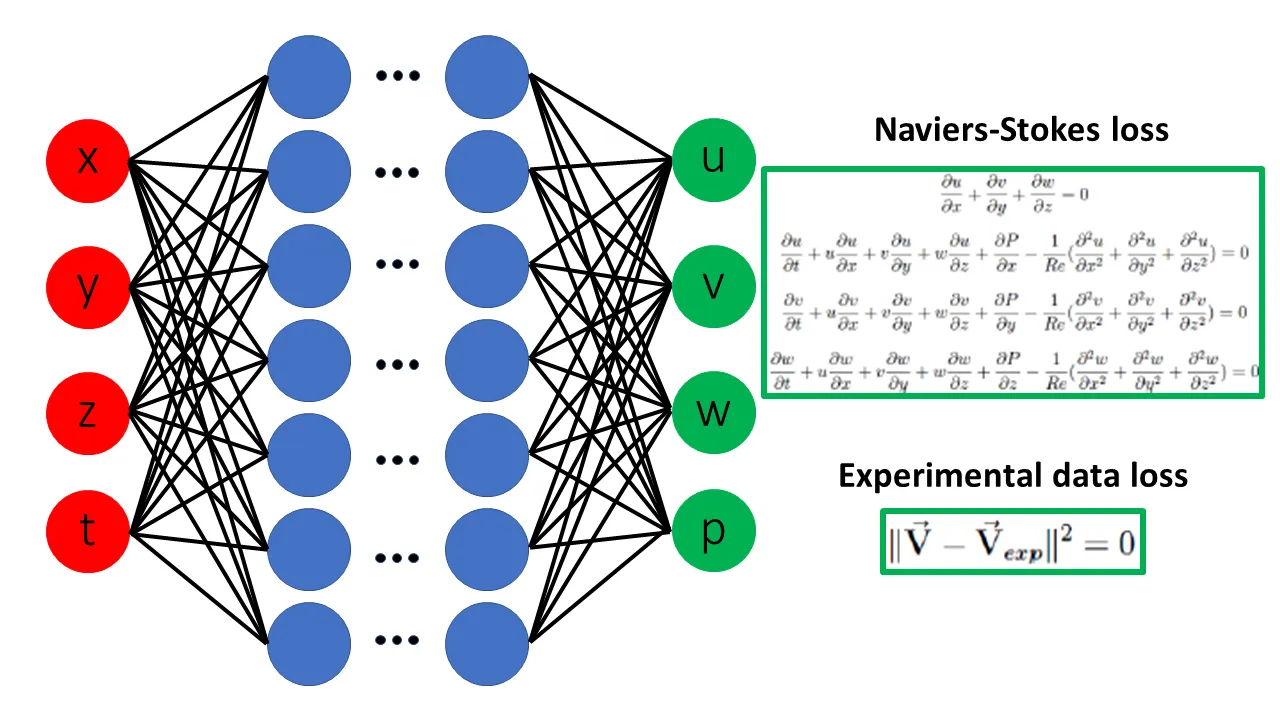 Estructura de flujo de una PINN: las coordenadas espacio-temporales $(x, t)$ ingresan a un perceptrón multicapa que genera la predicción $\hat{u}$; el motor de diferenciación automática calcula las derivadas parciales para construir el residuo de la ecuación física, sumándose a la función de pérdida total. Fuente: Wikimedia Commons / CC BY-SA 4.0.
1. La aproximación por red neuronal continua
En lugar de discretizar el dominio geométrico mediante una malla de tetraedros o cubos como en el método de elementos finitos (FEM), se define un perceptrón multicapa (Multilayer Perceptron, MLP) con parámetros entrenables $\theta = {W^{(l)}, b^{(l)}}_{l=1}^L$:
$$\hat{u}(\mathbf{x}, t; \theta) = \sigma \left( W^{(L)} \dots \sigma(W^{(1)} [\mathbf{x}, t]^T + b^{(1)}) \dots + b^{(L)} \right)$$
donde $\sigma(\cdot)$ es una función de activación suave y diferenciable a cualquier orden, como la tangente hiperbólica ($\tanh$) o la función exponencial sinusoidal ($\text{Sin}$, empleada en arquitecturas SIREN).
2. El operador residual y la diferenciación automática
Definimos el residuo de la física $r(\mathbf{x}, t; \theta)$ sustituyendo la salida de la red directamente en el operador diferencial:
$$r(\mathbf{x}, t; \theta) := \partial_t \hat{u}(\mathbf{x}, t; \theta) + \mathcal{N}_{\mathbf{x}}[\hat{u}(\mathbf{x}, t; \theta)]$$
Si la función $\hat{u}$ satisface a la perfección las leyes físicas de conservación impuestas por la EDP, el residuo se anula idénticamente en todo punto: $r(\mathbf{x}, t; \theta) \equiv 0$.
Aquí reside la elegancia del método: las derivadas parciales $\frac{\partial \hat{u}}{\partial t}$, $\frac{\partial \hat{u}}{\partial x_i}$, $\frac{\partial^2 \hat{u}}{\partial x_i \partial x_j}$ no se calculan mediante aproximaciones de diferencias finitas (como $\frac{\hat{u}(x+\Delta x) - \hat{u}(x)}{\Delta x}$), las cuales introducen errores de truncamiento y sufren severamente ante mallas irregulares. En su lugar, el grafo computacional de la red aplica la regla de la cadena analítica hacia atrás (reverse-mode automatic differentiation), evaluando las derivadas con precisión exacta a nivel de máquina.
3. Puntos de colocación libres de malla (mesh-free collocation)
Para evaluar el cumplimiento de la física, no se requiere tejer una malla interconectada. Basta con muestrear un conjunto discreto de $N_f$ puntos dispersos en el interior del dominio espacio-temporal, conocidos como puntos de colocación (collocation points):
$${(\mathbf{x}f^{(i)}, t_f^{(i)})}{i=1}^{N_f} \subset \Omega \times [0, T]$$
Estos puntos pueden distribuirse aleatoriamente mediante técnicas de diseño estadístico de experimentos, como el muestreo por hipercubo latino (Latin Hypercube Sampling, LHS) o secuencias cuasialeatorias de Sobol, garantizando una cobertura homogénea del espacio.
4. La función de pérdida multiobjetivo
El entrenamiento de una PINN consiste en resolver un problema de optimización no convexo donde la función de pérdida total equilibra múltiples demandas:
$$\mathcal{L}(\theta) = w_{\text{data}} \mathcal{L}{\text{data}}(\theta) + w{\text{pde}} \mathcal{L}{\text{pde}}(\theta) + w{\text{bc}} \mathcal{L}{\text{bc}}(\theta) + w{\text{ic}} \mathcal{L}_{\text{ic}}(\theta)$$
donde los términos cuadráticos medios se definen formalmente como:
- Pérdida en la EDP (Residuo físico): $$\mathcal{L}{\text{pde}}(\theta) = \frac{1}{N_f} \sum{i=1}^{N_f} \left| r(\mathbf{x}_f^{(i)}, t_f^{(i)}; \theta) \right|^2$$
- Pérdida en la frontera (Condiciones de contorno): $$\mathcal{L}{\text{bc}}(\theta) = \frac{1}{N_b} \sum{i=1}^{N_b} \left| \mathcal{B}[\hat{u}](\mathbf{x}_b^{(i)}, t_b^{(i)}; \theta) - h(\mathbf{x}_b^{(i)}, t_b^{(i)}) \right|^2$$
- Pérdida en el estado inicial: $$\mathcal{L}{\text{ic}}(\theta) = \frac{1}{N_0} \sum{i=1}^{N_0} \left| \hat{u}(\mathbf{x}_0^{(i)}, 0; \theta) - g(\mathbf{x}_0^{(i)}) \right|^2$$
- Pérdida en datos observacionales (si existen sensores): $$\mathcal{L}{\text{data}}(\theta) = \frac{1}{N_d} \sum{i=1}^{N_d} \left| \hat{u}(\mathbf{x}d^{(i)}, t_d^{(i)}; \theta) - u{\text{sensor}}^{(i)} \right|^2$$
Los coeficientes de ponderación $w_{\text{data}}, w_{\text{pde}}, w_{\text{bc}}, w_{\text{ic}}$ regulan la competencia entre los distintos objetivos durante el entrenamiento.
La dualidad fundamental: Problemas directos vs. Problemas inversos
El marco analítico de las PINNs exhibe una simetría deslumbrante al abordar dos clases antagónicas de problemas científicos:
1. El problema directo (Forward Problem)
En el problema directo, todas las ecuaciones y constantes físicas son perfectamente conocidas (por ejemplo, la viscosidad cinemática $\nu = 0.01$ y la densidad $\rho = 1.0$), junto con las condiciones iniciales y de frontera. La red actúa como un integrador numérico continuo: a través de la optimización con algoritmos como Adam seguido por L-BFGS (un optimizador cuasi-Newtoniano de segundo orden), la red converge hacia el campo de solución sin necesidad de generar costosas mallas de cálculo.
2. El problema inverso (Inverse Problem y descubrimiento de leyes físicas)
El problema inverso representa la verdadera joya de la corona del Machine Learning Científico. En la práctica experimental, a menudo se conoce la estructura matemática de una ley de conservación, pero se ignoran parámetros fundamentales del medio (como la conductividad térmica de una aleación avanzada, la permeabilidad hidráulica de un acuífero subterráneo o la viscoelasticidad de una arteria coronaria).
En una PINN, los parámetros desconocidos $\boldsymbol{\lambda} = {\lambda_1, \lambda_2, \dots}$ se incorporan directamente como variables entrenables en el grafo de cómputo junto a los pesos $\theta$ de la red. A partir de mediciones dispersas de unos pocos sensores distribuidos en el espacio, el algoritmo no solo reconstruye el campo continuo de velocidades o temperaturas en regiones donde no hay ningún sensor (super-resolución física), sino que deduce automáticamente el valor exacto de las constantes físicas constitutivas.
Aplicaciones de frontera: De la microcirculación a la manufactura aditiva
La versatilidad de las redes informadas por la física ha desencadenado una revolución aplicada en diversos campos tecnológicos:
- Hemodinámica y medicina personalizada:
Modelado del flujo sanguíneo pulsátil en aneurismas cerebrales y bifurcaciones aórticas. Al acoplar mediciones dispersas de resonancia magnética 4D con las ecuaciones incompresibles de Navier-Stokes, las PINNs pueden inferir la distribución de esfuerzos de cizallamiento en la pared endotelial (wall shear stress), un biomarcador crucial para anticipar rupturas vasculares. - Manufactura aditiva e impresión 3D láser:
Simulación de las transferencias térmicas ultrarrápidas y gradientes de fase en lechos de fusión por láser. La física de Stefan y las ecuaciones de conducción de calor no lineales permiten predecir esfuerzos residuales y deformaciones estructurales en componentes de titanio aeroespacial. - Geofísica y almacenamiento de carbono:
Inferencia de la dispersión de fluidos en medios porosos heterogéneos bajo las ecuaciones de Darcy-Brinkman, optimizando la captura subterránea de dióxido de carbono ($CO_2$) y la extracción geotérmica. - Gemelos Digitales (Digital Twins):
Despliegue de modelos sustitutos (surrogate models) ultraligeros que, una vez entrenados, se ejecutan en microsegundos dentro de microservicios en la nube, asimilando telemetría en tiempo real desde turbinas eólicas o reactores químicos para proyectar escenarios de fatiga de materiales.
Desafíos abiertos y limitaciones epistemológicas
Pese a su elegancia conceptual, la divulgación rigurosa exige reconocer que las PINNs no constituyen una panacea universal ni están exentas de graves dificultades teóricas:
- Patología de gradientes (Gradient Pathologies):
El paisaje de optimización de una pérdida multiobjetivo es altamente no convexo. Investigaciones lideradas por Sifan Wang y Paris Perdikaris (2021) han demostrado que los gradientes de los términos de frontera suelen diferir en varios órdenes de magnitud frente a los gradientes del residuo de la EDP, provocando que los optimizadores convencionales queden atrapados en mínimos locales espurios donde la red memoriza las condiciones de contorno pero viola la ecuación física en el interior. - Sesgo espectral (Spectral Bias):
Las redes neuronales estándar exhiben una fuerte tendencia a aprender con rapidez los componentes de baja frecuencia espacial, tardando una infinidad de épocas en resolver frentes de choque, capas límite o turbulencias de escala fina. - Violación de la causalidad temporal:
En problemas dependientes del tiempo, el entrenamiento global sobre el espacio-tiempo $\Omega \times [0, T]$ viola el principio de causalidad física: la red intenta ajustar el residuo en instantes futuros ($t = T$) antes de haber resuelto correctamente la dinámica en instantes tempranos ($t \to 0$), conduciendo al colapso de la simulación. - Coste frente a métodos clásicos:
Para problemas directos con geometrías sencillas y mallas ya construidas, los solucionadores clásicos de elementos finitos o volúmenes finitos (como OpenFOAM o Ansys) continúan siendo órdenes de magnitud más rápidos y computacionalmente económicos que el entrenamiento iterativo de una PINN. La ventaja de las PINNs radica en problemas inversos, dominios geométricos de altísima dimensión o cuando el mallado tradicional resulta computacionalmente intratable.
Para superar estas barreras, la investigación actual avanza hacia el aprendizaje de operadores continuos (Neural Operators), tales como DeepONet —desarrollado también por el equipo de Karniadakis— y los Fourier Neural Operators (FNO), diseñados para mapear directamente entre espacios funcionales de dimensión infinita.
Reflexión: La armonía entre el dato y la ley natural
El vocablo griego clásico physis (φύσις) aludía originalmente al orden intrínseco de la naturaleza, a su dinamismo creador y a las leyes invisibles que gobiernan el devenir de las cosas.
Durante años, la fascinación tecnológica por el poder del Big Data insinuó que las leyes analíticas concebidas por mentes como Newton, Euler, Fourier o Navier podían volverse prescindibles frente a la omnipotencia de los algoritmos ciegos. El auge de las Redes Neuronales Informadas por la Física refuta con serenidad esa soberbia reduccionista: nos recuerda que la inteligencia computacional alcanza su mayor grado de belleza y potencia no cuando sustituye a los primeros principios, sino cuando se arrodilla ante ellos para dejarse guiar por su verdad matemática.
Fuentes y lecturas recomendadas
- Raissi, M., Perdikaris, P., & Karniadakis, G. E. (2019): Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equations. Journal of Computational Physics, vol. 378, pp. 686–707. DOI: 10.1016/j.jcp.2018.10.045 | Preprint en arXiv:1711.10561.
- Raissi, M., Perdikaris, P., & Karniadakis, G. E. (2017): Physics Informed Deep Learning (Part II): Two-dimensional Navier-Stokes, Euler and Klein-Gordon Equations. arXiv:1711.10566.
- Lagaris, I. E., Likas, A., & Fotiadis, D. I. (1998): Artificial neural networks for solving ordinary and partial differential equations. IEEE Transactions on Neural Networks, vol. 9, no. 5, pp. 987–1000. DOI: 10.1109/72.712178.
- Karniadakis, G. E., Kevrekidis, I. G., Lu, L., Perdikaris, P., Wang, S., & Yang, L. (2021): Physics-informed machine learning. Nature Reviews Physics, vol. 3, no. 6, pp. 422–440. Nature Reviews Physics.
- Lu, L., Jin, P., Pang, G., Zhang, Z., & Karniadakis, G. E. (2021): Learning nonlinear operators via DeepONet based on the universal approximation theorem of operators. Nature Machine Intelligence, vol. 3, no. 3, pp. 218–229. arXiv:1907.04502.
- Wang, S., Teng, Y., & Perdikaris, P. (2021): Understanding and mitigating gradient pathologies in physics-informed neural networks. SIAM Journal on Scientific Computing, vol. 43, no. 5, pp. A3055–A3081. arXiv:2001.04385.
- Brown University CRUNCH Group: Scientific Machine Learning & Multiscale Modeling. Portal oficial del laboratorio de investigación dirigido por George Karniadakis. CRUNCH Group en Brown.