Vision Transformers y CNNs: Modelos Híbridos en el Diagnóstico Radiológico
Índice de contenido6›
En el ejercicio del diagnóstico asistido por computadora (Computer-Aided Diagnosis, CAD), el aprendizaje automático se enfrenta a una exigencia cualitativamente distinta a la de los problemas convencionales de visión artificial. Aquí, la optimización algorítmica no puede limitarse a maximizar una métrica promedio de exactitud global (Accuracy); se rige por un principio bioético fundamental emparentado con el adagio clásico «in dubio pro aegroto» (en caso de duda, en favor del paciente). En una radiografía de tórax, clasificar erróneamente a un individuo enfermo como sano —incurriendo en un falso negativo— puede postergar un tratamiento crítico frente a una neumonía bacteriana o una consolidación alveolar incipiente, con consecuencias irreversibles para la vida.
Durante casi una década, las redes neuronales convolucionales (CNNs) constituyeron el estándar paradigmático e incontestado para el análisis de bioimágenes. Sin embargo, la irrupción de los Vision Transformers (ViT) ha transformado radicalmente nuestra concepción del procesamiento espacial. Al integrar las fortalezas complementarias de las convoluciones profundas con la autoatención jerárquica en arquitecturas híbridas como CheX-DS, la inteligencia artificial médica alcanza una precisión y una sensibilidad diagnóstica sin precedentes.
De Würzburg a la visión artificial: orígenes de la mirada diagnóstica
El anhelo de escrutar el interior del cuerpo humano sin lesionar los tejidos vivos se materializó a finales del siglo XIX gracias al físico alemán Wilhelm Conrad Röntgen (1845–1923) (admirado por su rigor experimental intachable y su generosidad ética al declinar patentar sus descubrimientos para que pertenecieran libremente a la humanidad).
Nacido en Lennep (Prusia renana) en el seno de una modesta familia de tejedores y comerciantes de paño, Röntgen experimentó un camino académico sinuoso: en su juventud fue expulsado injustamente del Instituto Técnico de Utrecht acusado de haber dibujado una caricatura de un profesor que en realidad no había realizado. Lejos de desistir, superó las rigurosas pruebas de ingreso en el Politécnico Federal de Zúrich (ETH), donde completó su formación en ingeniería mecánica y física experimental bajo el magisterio de Rudolf Clausius.
El 8 de noviembre de 1895, mientras investigaba la luminiscencia producida por rayos catódicos en un tubo de vacío en el laboratorio del Physikalisches Institut de la Universidad de Würzburg, Röntgen observó un fenómeno insólito: una pantalla recubierta de cristales de platinocianuro de bario emitía una suave fluorescencia verde aun cuando el tubo se encontraba totalmente envuelto en grueso cartón negro. Röntgen denominó a esta radiación electromagnética penetrante e invisible «X-Strahlen» (rayos X, utilizando la variable matemática $X$ para denotar su naturaleza incógnita).
Semanas después, el 22 de diciembre de 1895, obtuvo la primera placa radiográfica médica de la historia: la mano de su esposa, Anna Bertha Ludwig («Hand mit Ringen», mano con anillos), donde las sombras opacas de las falanges y la alianza matrimonial se recortaban nítidamente sobre la penumbra circundante.
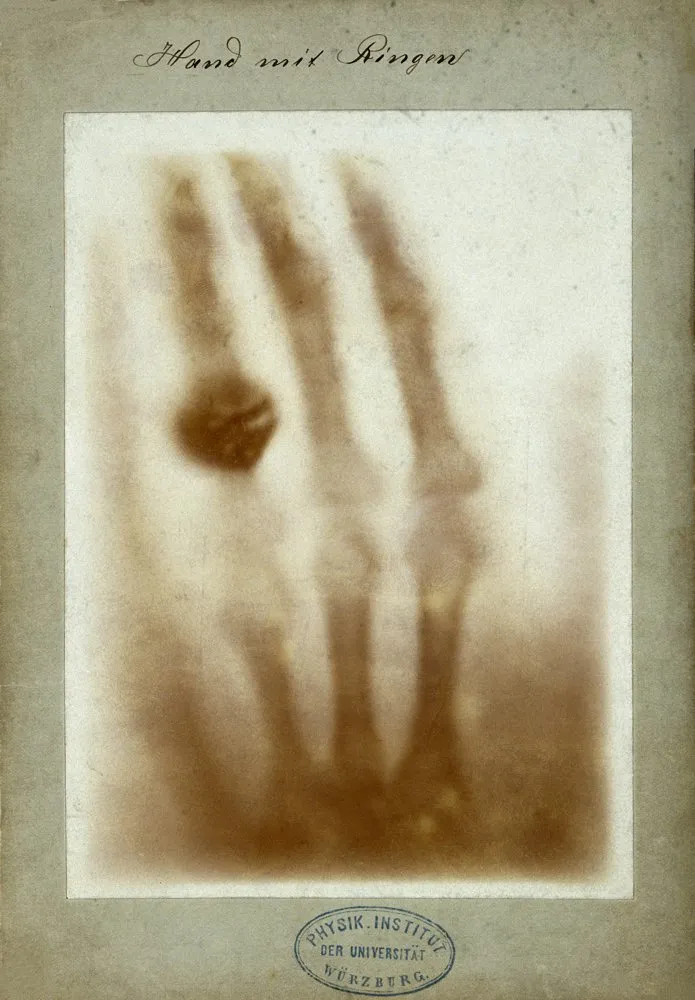 Fuente: Physikalisches Institut der Universität Würzburg / Wikimedia Commons (Dominio Público).
Durante más de un siglo, la interpretación de estas densidades radiológicas —aire negro, tejido blando grisáceo y hueso blanco— dependió exclusivamente del ojo clínico del radiólogo. Con el advenimiento de la computación masiva, surgió la necesidad de estructurar algoritmos capaces de asistir de forma cuantitativa y reproducible la lectura de estas sombras complejas.
El reinado de la convolución: sesgo inductivo y densidad conectiva
El primer salto cualitativo hacia la automatización diagnóstica moderna provino de las redes convolucionales profundas, cuyo sustento teórico fue consolidado por pioneros como Yann LeCun (admirado por su inquebrantable perseverancia durante los años de escepticismo académico hacia las redes neuronales). Inspiradas en los campos receptivos de la corteza visual primaria de los mamíferos descritos por David Hubel y Torsten Wiesel en Harvard, las CNNs introdujeron una restricción matemática fundamental: el sesgo inductivo (inductive bias) de invarianza y equivariancia traslacional.
Mediante núcleos de convolución discretos ($K$) de soporte espacial compacto que comparten sus parámetros de peso (weight sharing) sobre toda la extensión de la imagen $I$:
$$(I * K)(i, j) = \sum_{m} \sum_{n} I(i - m, j - n) K(m, n)$$
las CNNs aprendieron a extraer rasgos visuales jerárquicos (bordes tisulares, texturas granulares e infiltrados intersticiales) con un número de parámetros sumamente eficiente y sin importar la posición exacta de la patología en el plano torácico.
Sin embargo, a medida que las redes ganaban profundidad, emergía el escollo del desvanecimiento del gradiente (vanishing gradient problem). Para sortear esta degradación, Gao Huang y sus colaboradores formularon en 2017 la arquitectura DenseNet (Densely Connected Convolutional Networks). En lugar de limitarse a conexiones residuales aditivas, cada capa $\ell$ en un bloque denso recibe como entrada los mapas de características (feature maps) de todas las capas anteriores mediante concatenación tensorial:
$$\mathbf{x}\ell = H\ell([\mathbf{x}_0, \mathbf{x}1, \dots, \mathbf{x}{\ell-1}])$$
donde $[\dots]$ denota la concatenación a lo largo de la dimensión de canales. En patología pulmonar, DenseNet121 demostró una aptitud insuperable: preserva simultáneamente las frecuencias espaciales finas de las capas tempranas y las abstracciones semánticas profundas, facilitando la detección de opacidades tenues. Su debilidad intrínseca radica, empero, en su horizonte perceptivo: al procesar la imagen a través de ventanas locales limitadas, le cuesta articular relaciones contextuales complejas entre anomalías anatómicamente distantes (por ejemplo, derrames pleurales contralaterales o asimetrías de volumen en ambos hemitórax).
La revolución de la autoatención: de Vaswani al Swin Transformer
En 2017, un equipo de investigación en Google Brain encabezado por Ashish Vaswani publicó el histórico artículo «Attention Is All You Need», proponiendo el mecanismo de autoatención por producto escalar escalado (Scaled Dot-Product Attention) para la traducción automática:
$$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$
donde las matrices de consulta ($Q$), clave ($K$) y valor ($V$) proyectan linealmente las representaciones de los datos.
Tres años después, Alexey Dosovitskiy (admirado por su audacia matemática al derribar el dogma de que las convoluciones eran insustituibles en la visión por computadora) lideró el desarrollo del Vision Transformer (ViT) en Google Research. ViT fragmenta una imagen bidimensional en una secuencia unidimensional de parches discretos de tamaño fijo (típicamente $16 \times 16$ píxeles), proyectándolos como si fueran «palabras» sintácticas (tokens).
Pese a su extraordinaria capacidad para modelar dependencias de largo alcance en cualquier región del campo visual, el ViT estándar adolece de un costo computacional prohibitivo para la medicina: su cálculo de autoatención escala de forma cuadrática respecto al número de parches $N$:
$$\mathcal{O}(N^2)$$
En radiografías clínicas de alta resolución ($1024 \times 1024$ píxeles o superior), esta complejidad desborda la memoria de las unidades de procesamiento gráfico (GPU).
La solución a este dilema llegó en 2021 de la mano de Ze Liu y el equipo de Microsoft Research Asia con la creación del Swin Transformer (Shifted Windows). El Swin Transformer introduce dos innovaciones matemáticas cruciales:
- Atención en ventanas locales fijas ($M \times M$): limita la autoatención al interior de regiones confinadas de tamaño $M = 7$, reduciendo la complejidad a un régimen estrictamente lineal respecto al número total de parches: $$\mathcal{O}(4 M^2 N)$$
- Ventanas desplazadas (Shifted Window Partitioning): entre capas consecutivas, las fronteras de las ventanas se desplazan en $(\lfloor \frac{M}{2} \rfloor, \lfloor \frac{M}{2} \rfloor)$ píxeles, permitiendo el intercambio de información entre ventanas adyacentes y tendiendo puentes de atención global a través de una jerarquía piramidal multiescala.
La arquitectura CheX-DS: sinergia multiescala y formulación asimétrica
Frente a la encrucijada clínica entre la precisión local de las convoluciones y el alcance contextual de los Transformers, la arquitectura CheX-DS (Chest X-ray DenseNet & Swin) surge como una síntesis deliberada:
  Radiografía de Tórax
          │
          ▼
   ┌───────────────┐
   │  DenseNet121  │  --> Extracción de microtexturas y densidades focales
   └───────┬───────┘
           │ (Mapas de características enriquecidos)
           ▼
   ┌───────────────┐
   │SwinTransform. │  --> Relaciones globales y contexto bilateral
   └───────┬───────┘
           │
           ▼
   ┌───────────────┐
   │Pérdida Asimétr│  --> Castigo selectivo sobre Falsos Negativos
   └───────┬───────┘
           │
           ▼
Diagnóstico Auditado (Sensibilidad: 99% | Recall)- Flujo Híbrido: Las representaciones densas generadas por las etapas intermedias de DenseNet121 se proyectan como incrustaciones (embeddings) hacia las etapas del Swin Transformer, dotando al sistema de una doble perspectiva: microanálisis de la trama intersticial y macrolectura anatómica del tórax completo.
- Pérdida Asimétrica Ponderada (Weighted Asymmetric Loss, ASL): En las colecciones radiológicas hospitalarias, las patologías graves exhiben una marcada asimetría estadística frente a los estudios no reactivos. La función de entropía cruzada estándar resulta insuficiente porque los abundantes ejemplos negativos amortiguan el gradiente de aprendizaje. Para remediarlo, se implementó una función de pérdida asimétrica adaptada:
$$\mathcal{L}{\text{asym}} = - (1 - p_m)^{\gamma{+}} y \log(p_m) - \alpha p_m^{\gamma_{-}} (1 - y) \log(1 - p_m)$$
donde $y \in {0, 1}$ es la etiqueta clínica verdadera, $p$ es la probabilidad predicha, $\gamma_{+}$ y $\gamma_{-}$ son factores de modulación de focalización, $\alpha$ es un factor de ponderación de clase y:
$$p_m = \max(p - m, 0)$$
es una probabilidad desplazada por un margen $m \ge 0$. Este margen suprime íntegramente las contribuciones de los negativos fáciles ($p < m$), obligando al modelo a concentrar su capacidad matemática en afinar la frontera de decisión para los casos patológicos reales.
Bajo este esquema de entrenamiento, el modelo CheX-DS alcanzó un 99% de sensibilidad diagnóstica (Recall), logrando abatir la pérdida de prueba desde $1{,}03$ (en la línea base con ResNet50) hasta apenas $0{,}29$, garantizando que prácticamente ninguna consolidación pulmonar pase inadvertida.
De la formulación matemática al despliegue interactivo auditable
Un algoritmo predictivo carece de utilidad médica real si permanece encerrado en un cuaderno de experimentación o si opera como una «caja negra» impenetrable para los médicos. Para que una herramienta de aprendizaje profundo sea admitida en un entorno hospitalario, debe ser interpretable, reproducible y ergonómica:
- Interpretabilidad mediante mapas de atención (Attention Rollout):
Mediante la multiplicación recursiva de las matrices de peso de autoatención a lo largo de los bloques del Transformer, el sistema proyecta mapas de saliencia sobre la radiografía original. El especialista no solo recibe una probabilidad numérica, sino un mapa térmico donde se iluminan las regiones exactas que motivaron la sospecha diagnóstica. - Despliegue interactivo y contenedorización:
El pipeline fue empaquetado en una aplicación web interactiva con Streamlit, permitiendo la carga instantánea de archivos DICOM/PNG y la visualización paramétrica de los umbrales de decisión. Asimismo, todo el entorno fue encapsulado bajo Docker, garantizando paridad estricta de dependencias (versiones fijas de PyTorch, torchvision y CUDA) tanto en estaciones de diagnóstico locales como en clústeres hospitalarios en la nube.
La convergencia entre la física de los rayos descubierta en Würzburg, el rigor algebraico de los sesgos inductivos y la expresividad espacial de los Transformers demuestra que la computación no busca reemplazar el criterio médico humano, sino otorgarle una visión más profunda, auditable y serena para proteger la vida.
Fuentes y lecturas recomendadas
- The Nobel Prize in Physics 1901: Wilhelm Conrad Röntgen
Documento oficial de la Real Academia Sueca de Ciencias sobre la concesión del primer Premio Nobel de Física de la historia a Wilhelm Röntgen por el descubrimiento de los rayos X (X-Strahlen). - arXiv:2010.11929 — An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (Dosovitskiy et al., 2020)
Publicación fundacional del Vision Transformer (ViT) de Google Research, demostrando la eficacia de la autoatención pura en visión artificial sin núcleos convolucionales. - arXiv:2103.14030 — Swin Transformer: Hierarchical Vision Transformer using Shifted Windows (Liu et al., 2021)
Artículo técnico del Swin Transformer introduciendo el esquema de partición en ventanas desplazadas con complejidad computacional lineal. - arXiv:1608.06993 — Densely Connected Convolutional Networks (Huang et al., 2017)
Presentación formal de la arquitectura DenseNet, premiada como mejor artículo en CVPR 2017 por su mecanismo de reutilización densa de características. - arXiv:2009.14119 — Asymmetric Loss for Multi-Label Classification (Ben-Baruch et al., 2020)
Desarrollo matemático de la pérdida asimétrica con margen dinámico para el tratamiento del desbalance extremo de clases en clasificación multietiqueta. - arXiv:1711.05225 — CheXNet: Radiologist-Level Pneumonia Detection on Chest X-Rays with Deep Learning (Rajpurkar et al., 2017)
Estudio de referencia de Stanford Medicine sobre la aplicación de redes neuronales convolucionales profundas en la radiografía de tórax sobre el conjunto de datos NIH ChestX-ray14.